
こんにちは。ロリポップ・ムームードメイン事業部の nacal です。ゲームサーバーのホスティングサービス ロリポップ! for Gamers を開発しています。
for Gamersのテストの方針は、2年前におおよそ決まりました。当時の判断は次の記事で公開されています。
- 短期間での新規プロダクト開発における「コスパの良い」Goのテスト戦略(GMO Developers)
その方針は、「実際にちゃんと動くのか」を担保しながら、テストをコスパ良く書くことです。外部サービスと通信するとラージテストになるので、スタブサーバーに置き換えて1台のマシンの中で完結させます。スタブを書く工数はかかりますが、安定して速く走るテストと引き換えにその工数を受け入れていました。
ただし決済は例外でした。決済サービスにはテストサーバーがあり、それを使えば簡単にテストを書けます。記事には、スタブサーバーの実装コストも含めて考えた結果、外部と通信するコストを受け入れたと書いてあります。いま読み返しても妥当な判断です。テストの総量が少ないうちは、数分の遅れは許容できます。
記事の最後には課題も挙がっています。テストの実行時間が10〜20分に増えたこと、flaky testが増えたこと、ラージテストが無計画に増えたことです。その対策として、スタブサーバーの実装を進めてラージテストを削減する、と書かれています。
2年経って、その課題に自分が取り組むことになりました。サービスが育つとテストは増え、CIの待ち時間も伸びます。開発の進め方も変わりました。AIエージェントに実装を任せる比率が上がり、PRを出すまでの時間は短くなっています。一方でCIの実行時間は変わりません。手を動かしている時間よりCIを待っている時間のほうが長くなると、待ち時間の長さが急に気になり始めます。しかも決済のテストは遅いうえに、外部の都合でも落ちます。テストサーバーのレートリミットに引っかかるケースもその1つです。flaky testのなかでも、いちばん対処しにくい種類でした。
取り組んだ内容は、記事に書かれていたとおりです。httpstubを使って決済APIのスタブサーバーを書き、runnで書いたシナリオテストをそこに向けました。runnはYAMLで書いたランブックを上から順に実行するツールです。スタブは顧客とカードの情報を状態として保持し、3DSの認証フローまで再現します。
残るのは、決済まわりのサービス層を直接呼ぶGoのテストです。これも全部スタブに向ければ、外部の都合で遅くなったり落ちたりすることはなくなります。ただ、そうすると実物の決済APIで通るかどうかを誰も確かめなくなります。お金が動く処理で、それは避けたいところでした。
外部と通信することが目的のテスト
実際に決済のテストを見直すと、実物に向けていなければ意味のないテストが混ざっていました。
そうしたテストが検証していたのは、外部APIのリクエストとレスポンスの形式が、こちらの実装の想定と一致しているかで、いわゆるコントラクトテストです。
Pactのようなconsumer-driven contract testingとは異なります。Pactでは提供側も検証に参加しますが、外部の決済サービスがこちらのために検証してくれることはありません。今回のテストは、利用側のこちらだけが一方的に確かめるものです。
相手のAPIがこちらに断りなく変われば、この一致は崩れてしまいます。この記事では以降、相手のAPIが断りなく変わることをドリフトと呼びます。
このテストをスタブサーバーに向けたら、何も確かめていないのと同じです。実物のAPIと通信しなければ、こちらの想定が合っているかどうかは分からないからです。スタブに向けたテストは、「自分が想像した相手」に対するテストになります。速くはなりますが、もうコントラクトテストとは呼べません。
つまりこのテストは、外部と通信すること自体が目的でした。
この状況は、2年前の記事でも使われているテストサイズという分類で整理できます。『Software Engineering at Google』の定義がもとになっていて、1つのプロセスの中で完結するテストをスモール、1台のマシンの中で完結するテストをミディアム、複数のマシンにまたがるテストをラージと呼びます。
テストサイズは、テストスコープとは別の軸です。ユニットテストや結合テストといった呼び方はスコープの分類で、何をテストするかを表します。一方のサイズは、テストの実行にどれくらいコストがかかるかを表します。サイズは実行環境の境界という客観的な基準で決まるので、人によって解釈がぶれません。たとえばユニットテストでも、データベースにアクセスすればミディアムテストです。
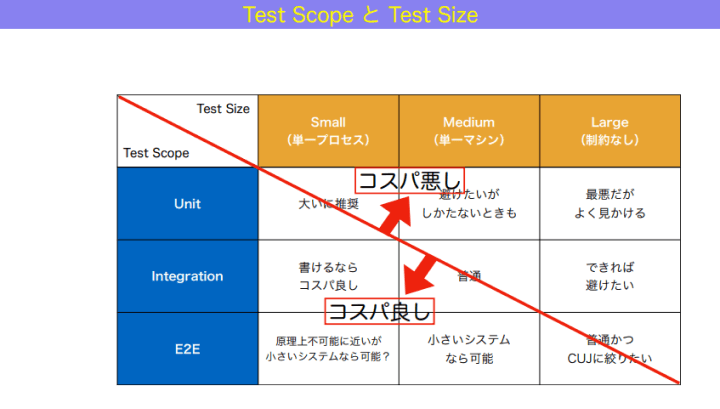
【t-wada】自動テストの「嘘」をなくし、望ましい比率に近づける方法【Developer eXperience Day 2024 レポート】 - レバテックLAB より引用
スコープとサイズの2軸で見ると、今回のテストの位置づけがはっきりします。スコープは狭く、外部APIとの境界だけを検証しています。それなのにサイズはラージです。スコープが狭いのにサイズの大きいテストは、費用対効果がいちばん悪い組み合わせです。
普通ならサイズを小さくするところでしょう。しかしこのテストはサイズを小さくできません。外部と通信するという目的が、ラージというサイズと切り離せないからです。
「スタブ化してミディアムに落とす」という方針は、すべてのラージテストに適用できるわけではありませんでした。ミディアムに落としてよいラージテストと、落としてはいけないラージテストがあります。両者を分けるのは、テストの目的がサイズに依存しているかどうかです。
「決済のテストは全部スタブ」とまとめて決めてしまうと、この違いは見えなくなります。スタブに向けるかどうかは、パッケージ単位ではなくテスト単位で決める必要がありました。
スタブと実物の相互依存
ただし、これはスタブ化の方針が間違っていたという話ではありません。スタブサーバーとコントラクトテストは、互いを必要とする関係にあります。
今回のスタブサーバーは手書きです。スタブのレスポンスは、こちらが想定した相手の仕様をもとに書いています。こちらの実装を変えるときは、スタブも同じ想定で直します。想定が間違っていれば、実装とスタブは一緒にずれていき、スタブはいつか「自分が想像した相手」になります。そうなると、実物では失敗する処理でもシナリオテストはすべて通ってしまいます。
そのずれを検知する仕組みが、実物を叩くテストです。スタブ化を進めるほど、実物を叩くテストは重要になります。実物を叩くテストについて考えるべきだったのは、消し方ではなく残し方でした。
なお、ベンダーが仕様から生成した公式のモックを提供している場合は事情が変わります。stripe-mockのようにモックがベンダーの仕様から作られていれば、こちらの想定ではなく相手の仕様に対してテストできます。それならミディアムテストに落とす判断がしやすくなります。for Gamersのスタブは手書きなので、こちらの想定が相手の仕様に合っているかは、実物を叩くテストでしか確かめられませんでした。
一部だけでも毎回は重い
実物に向けたまま残すテストは、決済のテストのうちひと握りです。それでも、毎回のPRで実行するには重すぎました。
実物を叩くテストをスキップして測り直すと、決済のテストの実行時間は数十分の一になります。残りのテストの時間を全部足しても、実物を叩くテスト1本の時間に届きません。
実物を叩くテストはいずれもテーブル駆動テストで、ケースごとに前提の状態を作っています。前提づくりには、シナリオテストのランブックを1本まるごと実行しています。カードを登録し、契約を1件購入し、定期課金を更新する、といった処理です。テストしたい操作の直前までの状態を、インターネット越しに決済サービスのテストサーバーで作っていました。
前提の状態を1回だけ作って使い回す方法も考えました。しかし返金のテストは対象の契約を消費するので、同じ契約を次のケースでは使えません。ケースごとに作り直すしかありませんでした。
その結果、テストしたい操作そのものより、前提を作るための通信の往復に時間がかかっていました。
遅いテストへの対処は、最後は速くするか消すかの二択になると考えていました。
このテストはどちらも選べませんでした。外部APIと通信するので速くはできず、外部と通信すること自体が目的なので消すこともできませんでした。
最後の関門でだけ実行する
残った選択肢は、テストを実行するタイミングを変えることです。毎回のPRで実行しなくても、本番に出る前のどこかで一度通っていれば、実物との整合は確かめられます。
候補は3つ出ました。
日次cronで実行する。 専用のワークフローを作って1日1回実行し、失敗したらSlackに通知します。通常のCIからは完全に外れるので、CIを速くする目的は達成できます。ただし、リリースを止めることはできません。cronの実行後に問題が起きて、そのままリリースすると、問題を含んだまま本番に出てしまいます。
決済コードを変更したPRで実行する。 pathsトリガを使い、決済関連のファイルを変更したPRでだけ実行します。決済のコードを変更した本人が、マージ前に問題を見つけられるのが利点です。ただし、実物のAPIとの整合を崩す変更は、決済のファイルの外からも入ります。たとえば決済のSDKのバージョンを上げる変更はgo.modに入るので、pathsの対象から漏れます。また、決済のPRではpushのたびに数分待たされます。加えて、ドリフトは相手側で起きるので、こちらがコードを変更していないときにも発生します。決済コードを誰も変更しない期間が続けば、その間はドリフトを検知できません。
mainへのPRのゲートにする。 mainへのPRでテストを実行し、失敗したらマージを止めます。for Gamersは基本的にdevelopからmainへのリリースPRでリリースしているので、実質的にはリリースのゲートになります。
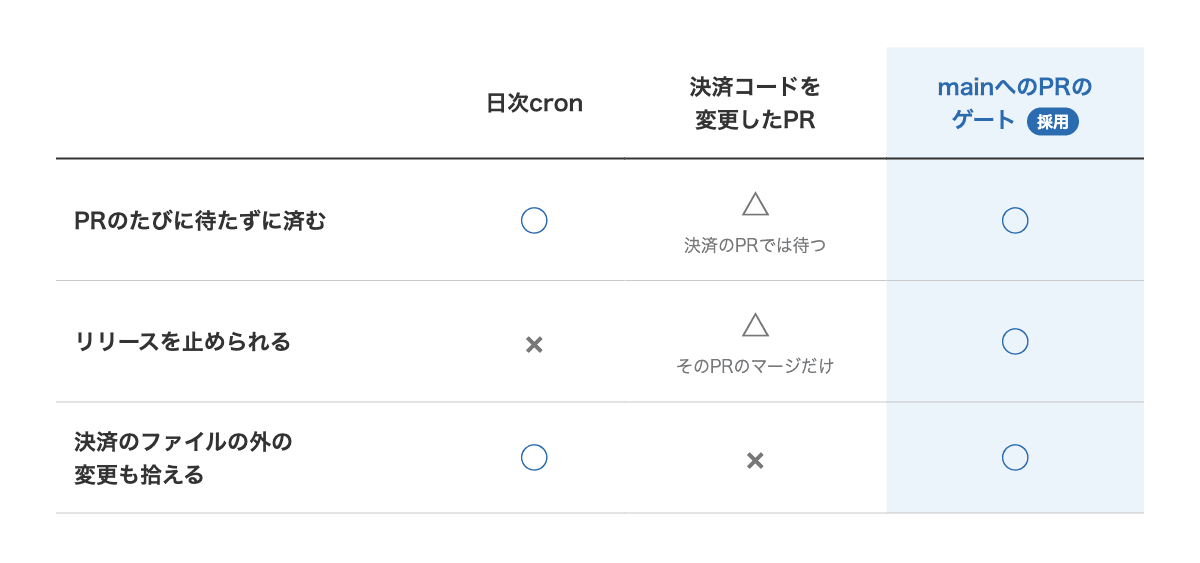
3つ目のmainへのPRのゲートを採用しました。テストサイズは変えていません。1回の実行にかかる時間も、ケースごとに前提を作り直す処理も同じです。変えたのは実行の頻度で、毎PRからリリースごとになりました。
ひとつのテストが兼ねる二つの役割
ここまでの説明には、ひとつ都合の悪い点があります。
このゲートには、バックエンドに差分がないPRではジョブごとスキップする条件を付けています。以前、外部APIの都合でゲートが失敗し、フロントエンドの表示を直しただけのリリースまで止まってしまったからです。
しかし先ほど、pathsトリガの弱点として、こちらのコードと無関係に相手のAPIが変わることを挙げました。その理屈に従えば、バックエンドの差分の有無でスキップするのはおかしいはずです。相手のAPIが変わるかどうかは、こちらの差分と関係ありません。
この矛盾は、このテストが二つの役割を兼ねていることから生じていました。
ひとつは、こちらの実装が相手の仕様に合っているかの検証です。この検証は、こちらのコードを変更したときに失敗します。
たとえば決済のSDKのバージョンを上げて、リクエストの組み立て方が変わったとします。このときスタブサーバーも、新しいリクエストに合わせて直すはずです。手書きのスタブはこちらの想定どおりに書かれているので、シナリオテストはすべて通ります。それでも実物のAPIはリクエストを受け付けない、ということが起こりえます。スタブがあるせいで気づけない失敗です。
もうひとつは、ドリフトの検知です。こちらのコードとは無関係に失敗します。
このうち後者のドリフト検知は、よく考えるとリリースゲートの役割ではありません。相手のAPIが変わった時点で、本番環境ではすでに不具合が起きています。リリースを止めても本番は直りません。ドリフトにはたいてい、リリースゲートより先に本番のエラーで気づきます。
リリースを止める価値がまったくないわけではありません。不具合が起きている状態のまま変更を重ねると、あとで原因を切り分けにくくなります。リリースを止めれば、それは避けられます。ただ、そのためだけに毎回のリリースで数分待つのは割に合いません。リリースを止めて効果があるのは前者、つまりこちらのコードが原因で失敗するときです。
つまりこのゲートが実際に守っているのは、こちらの実装と相手の仕様の統合でした。ドリフトの検知は、そのついでにできているにすぎません。
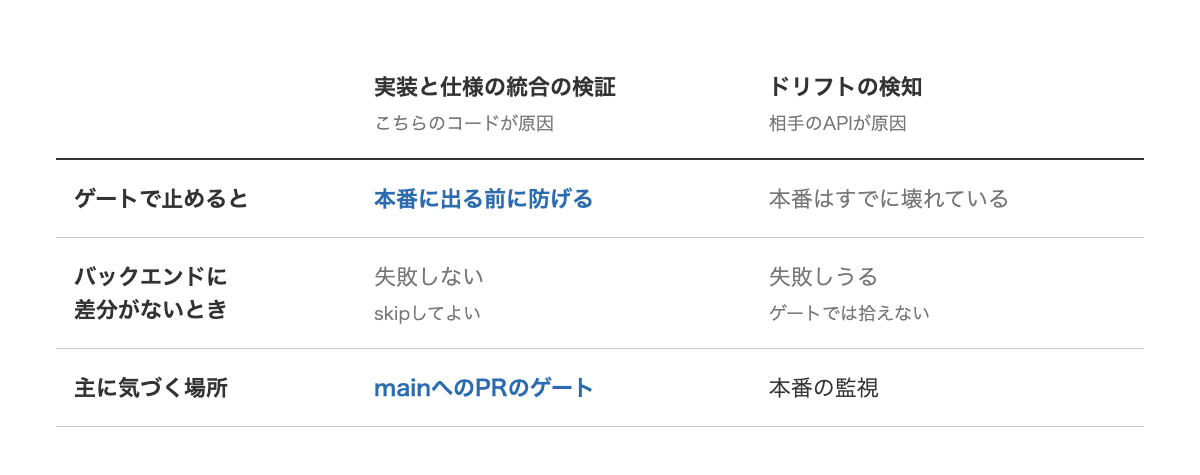
そう整理すると、バックエンドに差分がないときのスキップにも筋が通ります。守る対象がこちらのコードなら、こちらのコードが変わらないリリースでテストを実行する理由はありません。ドリフトを検知できる機会は減りますが、ドリフトの検知はもともとゲートが担う役割ではありませんでした。ドリフトを確実に検知したいなら、本番環境の監視で対応するべきです。
同じ理由で、pathsトリガの弱点のうちドリフトの検知は問題になりません。ただ、決済のファイルの外から入る変更を拾えないことと、PRのたびに待つことは残るので、ゲートを選んだ判断は変わりません。
保険として日次cronも併用するか迷いましたが、同じ理由でやめました。テストに監視の役割を持たせるのは筋が悪いと考えています。
最初からこう整理できていたわけではありません。いつ実行するかを決めていく過程で、このテストが何を守っているのかがようやく分かりました。
次に外部サービスが増えたとき
ここまでで当初の目的は達成できましたが、仕組みが決済API専用になっていました。for Gamersはゲームサーバーのホスティングサービスなので、決済以外にも外部サービスに依存しています。同じ問題は今後も起きるはずです。
そこで決済API専用だった環境変数とワークフローを、環境変数ひとつで実行を切り替える共通のヘルパ関数にまとめ直しました。
const RealAPIEnv = "REAL_API_TEST"

// 実APIを叩くテストの先頭で呼ぶ
func SkipUnlessRealAPI(t testing.TB) {
	t.Helper()
	if os.Getenv(RealAPIEnv) != "true" {
		t.Skip("skipping real API test")
	}
}
あとはREAL_API_TEST=trueを渡すMakefileのターゲットを用意し、ゲートのジョブからそのターゲットを呼び出します。外部サービスを叩くテストが今後増えたら、テストの先頭でSkipUnlessRealAPIを呼び、Makefileの対象に加えるだけです。ワークフローもゲートの設計も変更する必要はありません。
2年前の記事が挙げていた課題のひとつが「ラージテストの無計画な増加」でした。ラージテストが無計画に増えるのは、増やし方が決まっていないからだと思います。この仕組みを入れておけば、今後は管理された形でしか増えません。
まとめ
2年前の記事に残っていた宿題は「スタブサーバーの実装を進めてラージテストを削減する」でした。
シナリオテストと決済のテストの大半は、スタブ化してミディアムに落としました。通常のCIで外部と通信するテストはなくなり、外部のサーバーの都合でテストが落ちることもなくなっています。
一方で、外部と通信すること自体が目的のテストは落とせませんでした。ミディアムに落とせるテストとそうでないテストの境目は、テストの目的がサイズに依存しているかどうかです。落とせなかったテストはラージのまま残し、mainへのPRでだけ実行するように頻度を変えました。外部APIを叩くテストを増やすときの手順も決まっています。
頻度を決めるには、そのテストが何を守っているのかを先に整理する必要がありました。今回のテストが守っていたのは、こちらの実装と相手の仕様の統合です。守る対象がはっきりすると、いつ実行するべきかもおおよそ絞り込めます。
速くできず消すこともできない、と諦めているテストがあれば、そのテストが何を守っているのかを書き出してみてください。実行するタイミングが合っていなかったと分かるかもしれません。