
2026年度に新卒エンジニアとして入社しました、ロリポップ・ムームードメイン事業部 第一事業開発チームのゆっきーです。8月25日にリリースした「ロリポップ!AIゲートウェイ」の開発を担当しています。
今回の開発では、Codex+エージェント群による自律的な開発ループを構築しました。人間が寝ている間もエージェントがコードを書き、レビューし、テストする。プロジェクト発足から提供開始までの約7週間で、GitHub上に約600件のIssueを起票し、そのうち約450件をクローズしました。この記事では、Issue起票からレビュー、E2Eテスト、クローズまでを自動で回す仕組みの全体像と、運用して見えた成果・課題を紹介します。
「ロリポップ!AIゲートウェイ」とは
「ロリポップ!AIゲートウェイ」は、複数のAIプロバイダが提供するLLMを1つのAPIキーで利用できるマネージドAIゲートウェイです。2026年8月25日に提供を開始しました(プレスリリース)。
ロリポップは「動かす・届ける・つなぐ・使う」の4機能で構成されるAIインフラ基盤の構築を進めています。「ロリポップ!AIゲートウェイ」は「使う」を担うサービスとして、国内で不足していた日本円対応・日本語サポートの国産AIゲートウェイを提供するために開発されました。
この記事では開発プロセスに焦点を当てます。
なぜ自律型開発ループに至ったか
私は以前からCodexをカスタマイズし、日常的に開発に活用しています。Codex CLIはオープンソースで、動作を確認しながら連携を作り込めます。この点が決め手となり、「ロリポップ!AIゲートウェイ」の開発でも早い段階でCodexを採用しました。
ただ、最初から自律型開発ループの完成形を描いていたわけではありません。
当初は、Issue単位でAIエージェントに実装を任せ、テストと独立レビューを通せば安全に開発できると考えていました。しかし、実際の利用パターンをすべて想定し、必要なテストケースを漏れなく定義することは難しいと気づきました。実際、テストが通っていても、開発環境でブラウザから操作すると使えないケースが何度も見つかりました。
そこで、マージとデプロイの後に、実際の画面を操作するE2Eテストを追加しました。問題が見つかった場合は、E2Eテストを担当したエージェントが同じセッションで通信ログ・サーバーログ・データベースの状態を調べ、原因を特定します。そのまま実装を修正し、再レビュー・再テストを繰り返すことで、Issueの起票からクローズまでを1つのループとして回せるようになりました。
自律型開発ループの全体像
実装やレビューなど、役割ごとに立ち上げたCodexのセッションをエージェントとして動かしました。この開発ループは、以下の7ステップで構成されます。
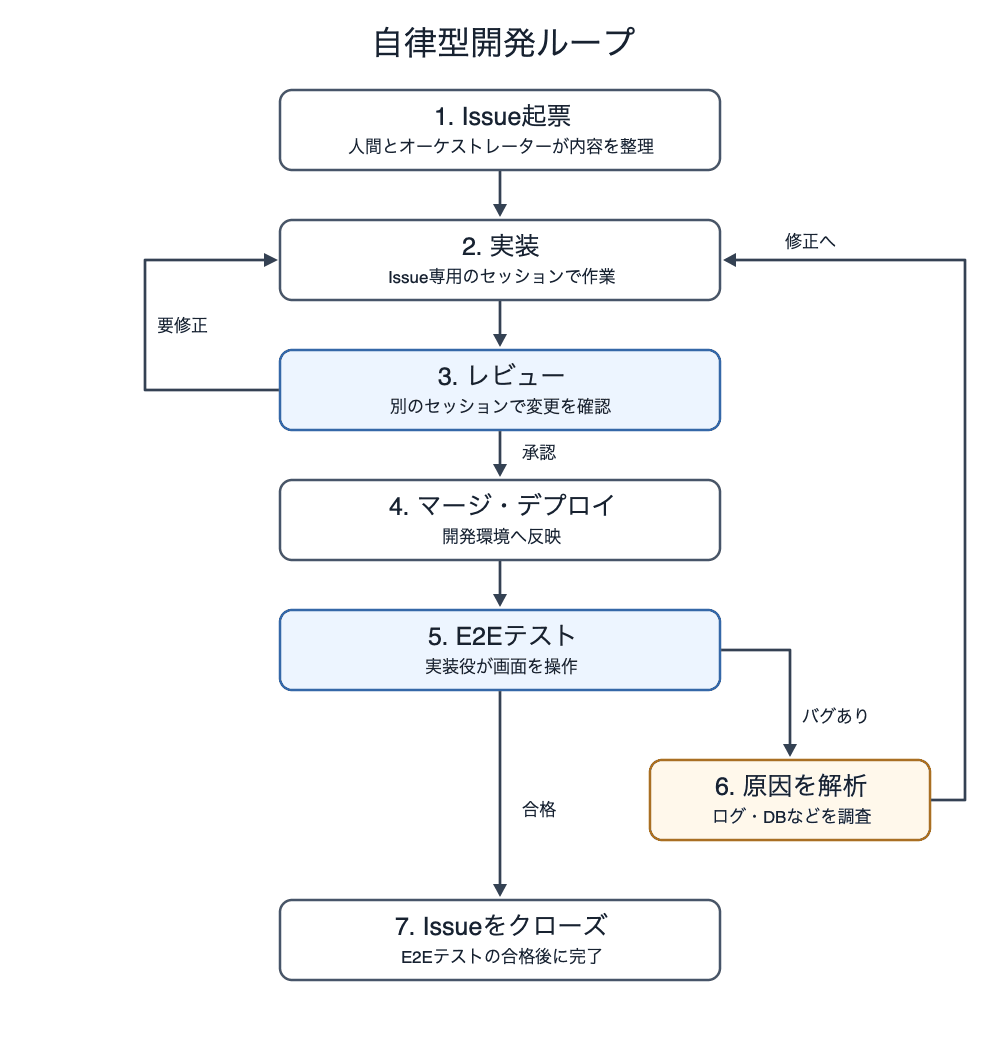
1. Issue起票:人間がオーケストレーター役のエージェントと会話してIssueを作成します。リリース前で本番への影響がない時期だったため、Issueは機能単位で分割しました。
2. 実装:Issueが作成されると、そのIssue専用の実装用セッションが立ち上がります。
3. レビュー:実装が完了すると、レビュー専用のセッションが立ち上がります。要修正と判定された場合は実装用セッションに差し戻し、レビューが通るまで実装とレビューのループを繰り返します。
4. マージとデプロイ:レビューが通るとマージし、CD(継続的デリバリー)で開発環境にデプロイします。
5. E2Eテスト:デプロイ後、実装用セッションをCodex Appに認識させ、in-app browser(アプリ内ブラウザ)で新規アカウントを使ったE2Eテストを実行します。テストの操作は実装エージェント自身が担います。自らが書いたコードの画面を操作するため迷わず進められ、テストの精度が高くなります。
6. バグ検出時の再分析:E2Eテストでバグを検出した場合、テストを担当した実装エージェントが同じセッションで通信ログ・サーバーログ・DBの状態を調べます。第三者が同じ手順で検証できる事実を根拠に原因を特定してから修正し、再レビュー・再テストへ進みます。
7. クローズ:E2Eテストが通った時点でIssueを閉じ、実装やレビューに使ったエージェントのセッションもすべて終了します。
実装にはGPT-5.6 Lunaを推論設定maxで使います。独立レビューでは、見落としが後工程の手戻りにつながるため指摘の質を重視し、GPT-5.6 Solを推論設定lowで使います。E2Eテストでバグを見つけた場合も、担当エージェントが同じセッションでSolのlowに切り替え、複数の可能性を根拠から絞り込んで原因を解析します。原因を特定したらLunaのmaxに戻して修正します。Solの推論設定をlowにすることで、速度とコストのバランスを取っています。
ナレッジベースによるコンテキスト共有
開発ループを機能させるには、全エージェントがリポジトリの実装内容を把握している必要があります。実装役が既存コードを知らなければ整合性のないコードを書きますし、レビュー役がコードベースを知らなければ的外れな指摘をします。この課題を解決するために、Codexの/compactの挙動を利用してナレッジベース(以下、KB)を構築しました。
リポジトリ全体の知識をエージェントに持たせる
私がKB構築の方法に気づいたのは、Codexが複数の圧縮コンテキストを保持した状態からセッションを開始できるか検証していたときです。/compactでリポジトリを分割して圧縮したコンテキストを作り、それらを保持するセッションを複製すれば、同じ知識を持つエージェントを起動できると分かりました。KBの実装はGitHubで公開しています。
KBの規模と分割サイズの設計
リポジトリは約1,560ファイル・約37万行で、KBの生成対象は約424万トークンでした。これを1つあたり最大150Kトークン(平均約11.5万)に、ディレクトリ単位で分割し、37個の圧縮コンテキストを生成しています。KB全体の構築には約12分かかりました。
150Kトークンという分割サイズは比較実験から決めました。約437Kトークンを一度に圧縮すると出力が約1.1Kトークンまで縮みましたが、約150Kトークンに分けると1チャンクあたり約3.5Kトークンの情報が残りました。入力が大きすぎると圧縮時に細部が失われるため、情報量と処理単位のバランスがよかった150Kを採用しています。
実装役・レビュー役・オーケストレーター役を、全員同じ知識を持った状態で立ち上げられます。E2Eテストでも、実装を理解しているエージェントが画面を操作するため、テストがスムーズに進みます。KBの整備は定期的に自動実行しており、維持コストはほぼかかっていません。
成果と課題
自動化がもたらしたもの
提供開始までに約600件のIssueを起票し、約450件をクローズしました。仕様整理や調査目的のIssueも含まれていますが、実装のほぼすべてをAIエージェントが担当しています。クローズしたIssueのうち計測できたものについて、起票からクローズまでの所要時間は中央値で約2時間でした。この所要時間には、起票から着手までの待ち時間も含まれます。履歴から確認できる範囲では、平均すると2件のIssueにつき1回程度のレビュー差し戻しが発生しています。
レビュー指摘の修正やE2Eテストでのバグ修正は、エージェント内部で何度も発生しています。ただし、すべて自動で完結するため、人間が手戻り対応をする場面はありませんでした。
退勤前に認証・認可やE2E基盤に関する5件のIssueを起票したところ、翌朝までに5件すべてがPR経由でクローズされていました。退勤前にIssueを立てておけば翌朝にはエージェントが処理を終えている、というリズムが自然に成立しました。
人間の役割はどう変わったか
自律型開発ループが定着してから、私の仕事は明確に変わりました。コードを書く時間は減り、代わりにIssueの設計やDB設計、テスト戦略の検討に時間を使うようになっています。業務の中心は「何を自動でさせるか」を決めることと、エージェントが快適に動ける環境を整えることです。
Issueさえ作ればオーケストレーターがクローズまで自動で回してくれるので、エージェントとのやりとり自体にはあまり時間を取られません。
AIと協働する上で見えた3つの課題
エージェントに開発を任せる中で、3つの課題が浮かび上がりました。
課題1:頼んでいないコードを足し、必要なテストを省く
要件を渡すと、頼んでいない抽象化や防御コードの複製、「ついで」の変更を盛ってきます。一方で、肝心のテストは「入れたものが入っている」ことを確かめるだけの、意味のないアサーションを書いてきます。YAGNI(You Aren’t Gonna Need It=今必要ないものは作るな)と指摘すると、今度は必要なものまで削りすぎます。
最終的に、要求との一致を基準にし、過剰と不足を同じ重さの欠陥として扱うことをレビュー基準に明文化しました。
課題2:事実と仮説を混ぜてくる
もっともらしい調査報告の中に、検証していない推測が混ざります。「見つからなかった」を「存在しない」と報告してくるのは典型的なパターンです。これを信じて進め、手戻りになるケースがありました。
対策として、事実には第三者が再現できる根拠(実行したコマンドとその出力、出典と引用)を必ず添えさせるルールを設けました。
課題3:デバッグに必要な情報を勝手に削る
エージェントが、デバッグに必要な情報を暗黙的に削ってしまうケースがありました。たとえば、catchブロックでエラー原因を破棄したり、型をunknownで誤魔化したり、テストの変数名をAやZのような無意味な記号にしたりします。その場では動いても、後で不具合が起きたときに原因を追う手がかりが足りず、調査が難しくなります。
この課題への対策として、セッション中に個別に注意を伝えるのではなく、エージェントが常に参照する開発原則をAGENTS.mdに明文化しました。エラー情報の省略を実装上の欠陥として扱うこと、処理継続時も原因を伝播または記録すること、型・スキーマ・制約で仕様を表現すること、人間が読める名前を使うこと、秘匿情報は残さず判断や失敗の経緯は残すこと。機械的に検査できるものは型・テスト・CIに落とし、それ以外は独立レビューで確認しています。
3つの課題を通じて、エージェントへの指示やレビュー基準を具体的にする重要性を感じました。
今後の展望
記事で紹介した自律型開発ループは、本番に影響しない開発環境で回していたものです。今後はデプロイが本番環境に影響するため、変更を反映する前の確認や、問題が起きたときに戻す手順を整えていきます。
「人間の役割」で触れたIssueの設計では、起票前に要件と受け入れ条件を詰める工程が現在のボトルネックです。現在は、音声入力による対話、質問を重ねて要件を詰めるgrilling、KBを組み合わせ、人間の意図をIssueへ落とし込む工程の効率化を進めています。
まとめ
Codex+エージェント群で実装役とレビュー役を分離し、自律型開発ループを回す仕組みは、プロダクト開発の現場で実用的に動きました。リポジトリ全体を圧縮したKBによって全エージェントに同じ知識を持たせられたことが、開発ループを支えています。
エージェントに開発を任せるようになって、私の仕事は「コードを書くこと」から「何を作るかを正確に定義すること」に変わりました。AIツールなしでは、これほど多くのIssueを短期間で進めることはできませんでした。一方で、何を作り、どの振る舞いを確かめるかは人間の判断です。起票前に要件と受け入れ条件を詰める仕事の重要性を、この開発を通じて実感しています。
新卒1年目でこの規模の開発を主導できたのは、AIツールの力だけでなく、挑戦を任せてくれるチームの存在が大きかったと思います。