はじめに
こんにちは。SUZURI・minne事業部 minneグループのtossy(@tshk_sakai)です。
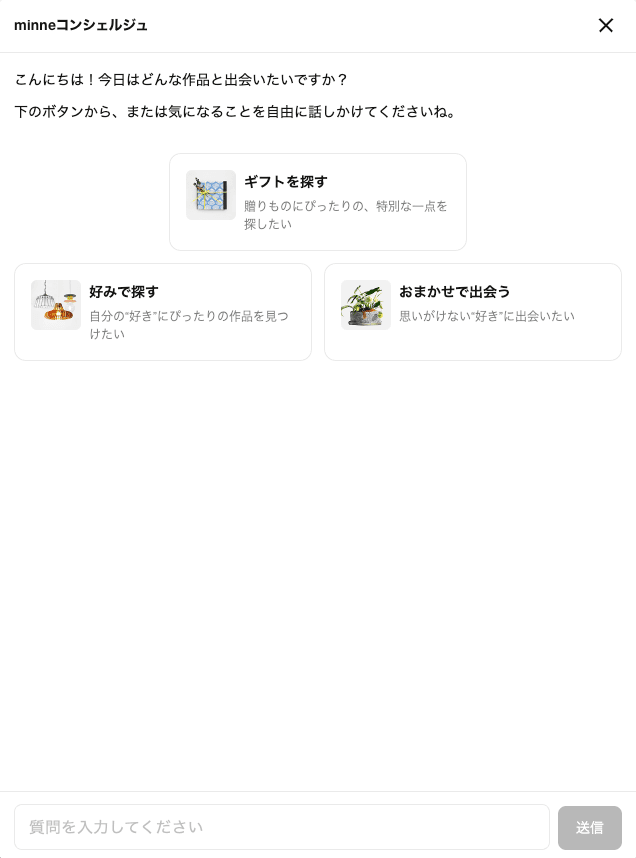
2026年8月6日に、ハンドメイドマーケットminneで「minneコンシェルジュ」を公開しました。 minneコンシェルジュは、AIエージェントと対話することで作品を探すことができる機能です。
今回、AIエージェントの実行基盤にAmazon Bedrock AgentCore(以下、AgentCore)を採用しました。 AgentCoreは2025年10月にGAとなった新しいマネージドサービスで、AIエージェントを迅速に本番環境へ導入できるサービスです。
この記事では、minneコンシェルジュのアーキテクチャと、AIエージェントを本番サービスへ導入する際の工夫を紹介します。
minneコンシェルジュとは
minneコンシェルジュは、会話をすることで新しい作品に出会える機能です。 minneには1800万点を超える作品があり、キーワード検索やカテゴリ検索などで作品を探せます。
海外や日本のECサイトでは、サイト上のAIアシスタントへ相談して商品を推薦してもらう体験が広がりつつあります。 しかし、これまでminneでは「母の日に3,000円くらいで上品なアクセサリーを贈りたい」のような会話をしながら作品を探すことは提供できていませんでした。 そこで、minneで作品を探す際に、対話でユーザの要望を確認しながら、作品を提案する機能を提供することを目指しました。
なぜAmazon Bedrock AgentCoreを選んだか
minneのサービスの大部分はAWSで稼働しており、既存の資産を活用することで、開発工数をなるべく少なくしたいと考えました。 既存の資産を用いることで、認証やIAMによる権限制御、監視等の仕組みをそのまま活用できます。
AgentCoreは、エージェントの本番運用に必要な要素を複数提供しており、 要素を自由に組み合わせることで状況に応じた開発が可能です。
- AgentCore Runtime:エージェントのサーバレス実行基盤
- AgentCore Memory:会話履歴の保存先
- AgentCore Identity:認証、認可の管理
- AgentCore Gateway:外部APIなどをMCPサーバとして公開
- AgentCore Observability:エージェントの動作状況の監視
- AgentCore Evaluations:エージェントの品質評価
今回は、AgentCore IdentityとAgentCore Gatewayは既存の資産があるため、利用しませんでした。
このように、既存のAWSの資産をそのまま活かしながら、エージェントの実行基盤や監視といった運用の土台を自前で構築せずに済むため、AgentCoreを採用しました。
エージェント本体は、AWSがOSSとして公開しているエージェントフレームワークのStrands Agentsで実装しました。
全体アーキテクチャ
minneのメインアプリケーションはAWS上のRuby on Railsで動作しています。 また、フロントはNext.jsで実装されています。全体の構成は以下の通りです。
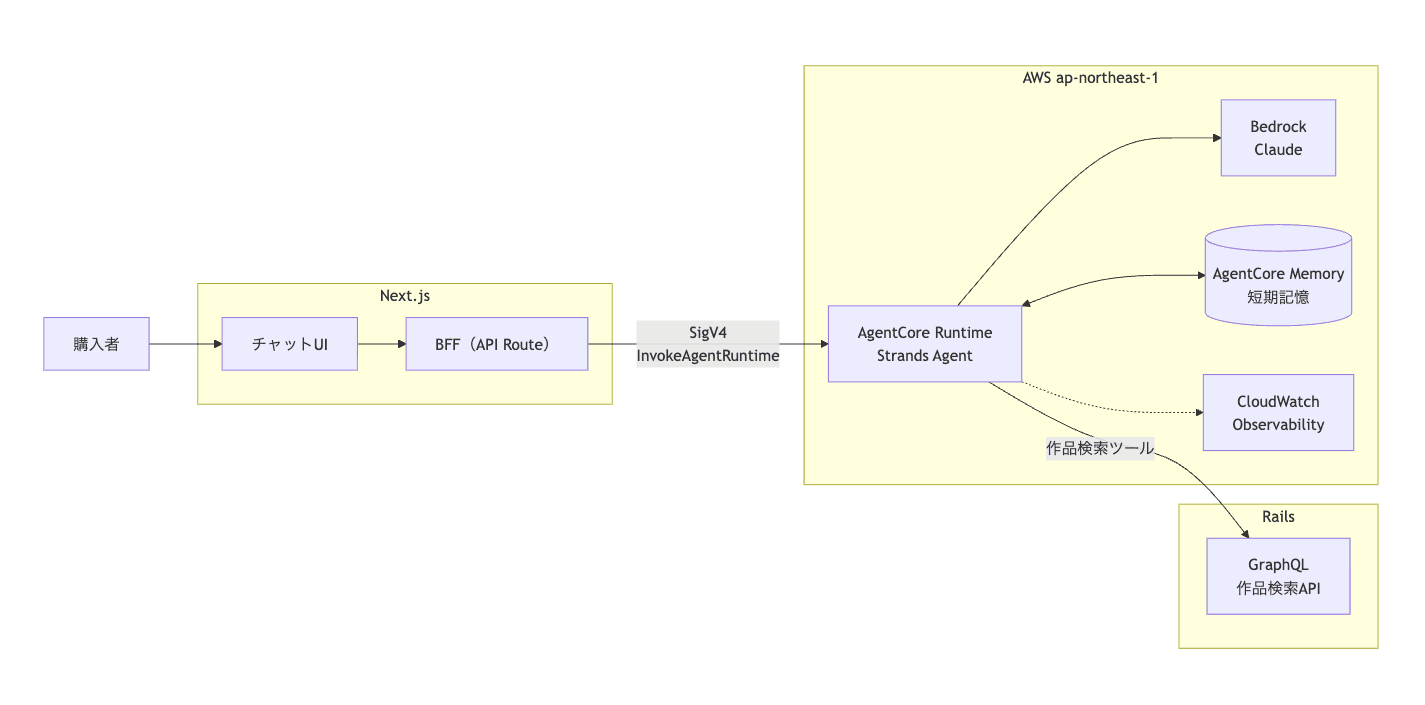
- チャットUI:フロント(Next.js)に実装したチャットウィジェット
- BFF:フロントのAPIエンドポイント。ブラウザからのリクエストを受け、ログイン確認のうえSigV4署名つきでAgentCore Runtimeを呼び出す
- Strands Agent:エージェント本体。システムプロンプトと作品検索ツールを持ち、Bedrock上のClaudeで応答を生成する
- 作品検索ツール:エージェントからRailsの作品検索APIを呼ぶツール
次に、設計上のポイントを2つ紹介します。
BFFはNext.jsのAPI Routeに置く
意図しないユーザがエージェントを呼び出さないように、インバウンド認証を設定する必要があります。
今回はIAM認証でAgentCore Runtimeを呼び出すため、InvokeAgentRuntimeにはSigV4署名が必要であり、ブラウザから直接呼ぶことができません。
そこで、フロントのAPI RouteをBFFとし、PodにIRSAでbedrock-agentcore:InvokeAgentRuntime権限を付与しました。
したがって、ユーザーからAgentCore Runtimeへ直接到達する経路はなくなり、エージェントの呼び出しは認証済みユーザーからのBFF経由のリクエストに限定されます。
作品データは既存の作品検索API経由で取得する
エージェントの作品検索ツールは、検索エンジンを直接参照せず、Railsの作品検索APIを呼びます。 エージェントからの検索の候補には、検索エンジンを直接参照する案と、Railsの作品検索APIを経由する案の2つがありました。
検索エンジンを直接参照する構成は、Railsを経由しない分、応答速度の面では有利に見えます。 しかし、公開状態や在庫、作家のステータスといったビジネスルールはRails側に実装されており、直接参照するとエージェント側での再実装が必要になります。 そのため、エージェント側でのビジネスロジックの再実装を防ぐため、Railsの作品検索APIを経由する案を採用しました。
本番公開までの工夫
ここからは、AgentCoreを用いた際の本番公開までの工夫をいくつか紹介します。
LLMに任せる範囲を決める
AIエージェントをサービスに取り込むうえで重要だったことは、LLMに任せる範囲を決めたことです。
例えば、ユーザとの会話の中で出てきた「予算」や「納期」などの条件は、決定的としたい制約となります。 この場合、プロンプトによる制御は確率的であるため、システムプロンプトの指示のみでは、出力が安定しません。
そこで、minneコンシェルジュでは、LLMの役割として「会話を検索引数に翻訳する」ようにしました。 例えば、「母の日に3,000円くらいで上品なアクセサリーを」という入力があった場合、LLMがキーワード、価格上限、納期などを抽出し、作品検索APIの引数に変換します。
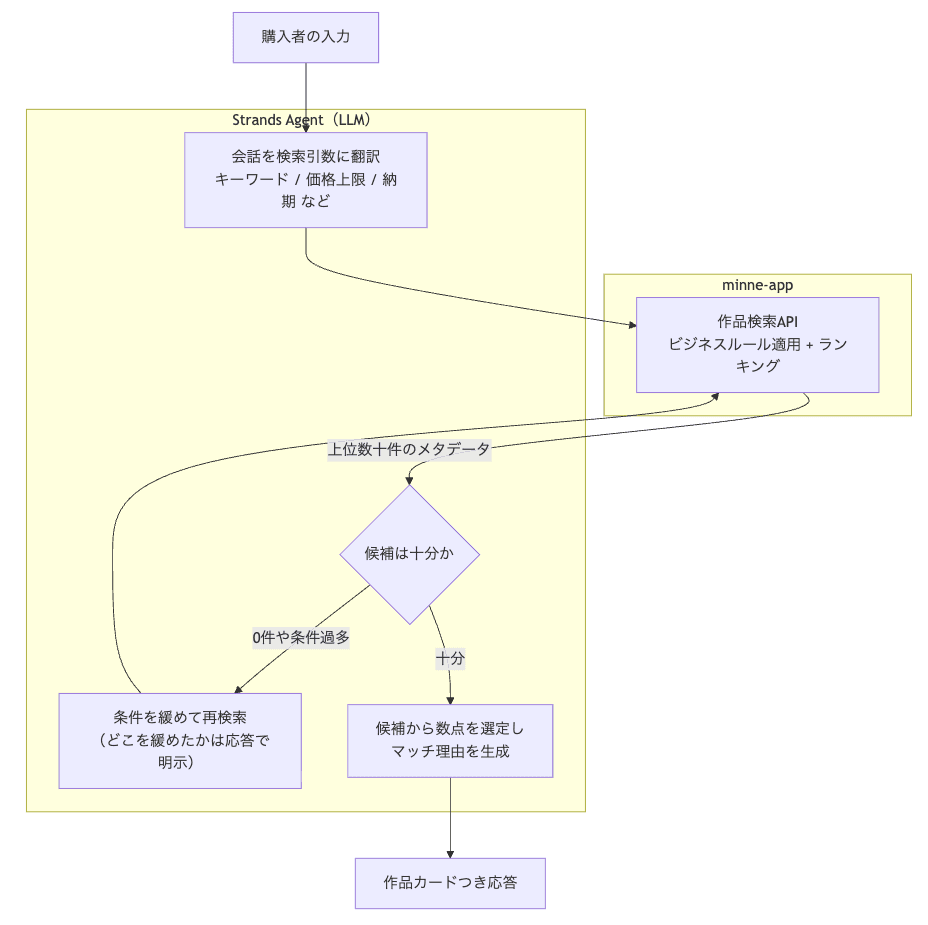
結果として、会話から出てきた条件をなるべく決定的とできるようにしました。
ガードレールを作る
LLMを用いた機能は、コストの濫用やプロンプトインジェクションのリスクがあります。 公開前にリスクを洗い出し、次のガードレールを実装しました。
- ログイン必須:未認証リクエストはLLMへ到達する前に401で遮断する
- 会話履歴のユーザー単位での分離:会話履歴は認証済みユーザーに紐づけてサーバー側で分離し、他のユーザーの会話履歴にはアクセスできないようにする
- 入力文字数の上限:長文の入力による入力トークンの増加を防ぐ
- フィーチャーフラグによる緊急停止:フラグを無効化することでAPIを遮断
- WAFによるレート制限:WAFでレート制限をかける
- Amazon Bedrock Guardrails:プロンプトインジェクション対策として導入
Amazon Bedrock Guardrailsについては「AWS Bedrock Guardrails / 機密情報の入力・出力をブロックする」も合わせてご参照ください。
逐次表示による応答体感の改善
AgentCore Runtimeはセッションごとに専用のmicroVMを起動する仕組みのため、新しいセッションの最初の呼び出しではコールドスタートが発生します。 公開前の検証で、コールドスタート時の応答が実測約40秒に達し、CloudFrontのタイムアウト(既定30秒)で切断される問題が見つかりました。
対策のため、まずトレースを使って1回の応答を処理の段階ごとに分解しました。 すると、応答時間の大半をLLMの推論が占めており、検索などの処理は一部にすぎないことがわかりました。 推論そのものを短縮して30秒以内に収めるのは難しいため、2段階で対策しました。
- 緩和策:プロンプトキャッシングの導入と、出力の簡潔化
- 根本対策:エージェント、BFF、UIを通したストリーミング応答(SSE)への対応
ストリーミング化により、応答の生成が完了する前に逐次表示が始まるため、生成に時間がかかってもタイムアウトで切断されなくなりました。 結果として、ストリーミング応答による逐次表示で、応答体感を改善できました。
コスト管理と利用状況の計測
LLMを使う機能は、公開後のコスト管理および利用状況の計測が重要です。 公開後にAPIが異常な数呼び出されていないか、どのくらい会話が行われているか、を把握したいためです。
コスト面では、一定期間にLLM推論コストがある閾値を超えた場合、Slackへ通知するようにしました。 また、モデル呼び出しを専用のapplication inference profileに分離することで、Cost Explorerでminneコンシェルジュ単体のコストを計測できるようにしました。
利用状況の計測においては、チャットの表示、メッセージ送信、作品表示などの利用イベントをBigQueryへ送り、ダッシュボードで指標をモニタリングできる状態としました。 BigQueryへ送るのは行動ログのみで、会話の本文は送っていません。 公開後は、利用数や購買への寄与度を数値で評価しています。
会話品質の評価
前項の計測でわかるのは、利用数や購買への寄与といった指標です。 一方で、「ユーザの意図を正しく理解できたか」「提案は適切だったか」といった会話の「質」は、イベント計測では捉えられません。
そこで、会話品質の評価にはAgentCore Evaluationsを利用しています。 Evaluationsは、Observabilityが記録したトレースを入力として、LLM-as-a-Judge方式で会話を評価できる機能です。 組み込みの評価観点(Built-in Evaluator)に加えて、自然言語などで独自の評価観点(Custom Evaluator)を定義できます。 実際の会話のトレースをそのまま評価の入力にできるため、評価用のデータセットを別途用意しなくても、品質を確認できます。
今回はバッチでの評価により、組み込みの評価観点であるGoalSuccessRate / Helpfulness / Harmfulnessを確認しました。
- GoalSuccessRate:ユーザの目標を達成できているか
- Helpfulness:ユーザにとって役立つ回答ができているか
- Harmfulness:有害なコンテンツを含んでいないか
これにより、エージェントがユーザの目標達成に寄与しているか、安全に回答ができているか、を評価できました。 今回はバッチでの評価をしましたが、今後オンライン評価等を導入することで、コード変更の度に会話品質を数値で確認しながら改善することが可能となります。
まとめ
Amazon Bedrock AgentCoreとStrands Agentsで構築した「minneコンシェルジュ」のアーキテクチャと、本番公開までの工夫を紹介しました。
AgentCoreは、Runtime、Memory、Observabilityといった本番運用に必要な要素がマネージドで揃っているため、エージェント本体のロジックに集中して開発できました。 AIエージェントの本番導入を検討している方の参考になれば幸いです。